分布式存储如何工作?以及它如何通过冗余设计防止数据丢失?
-
目录
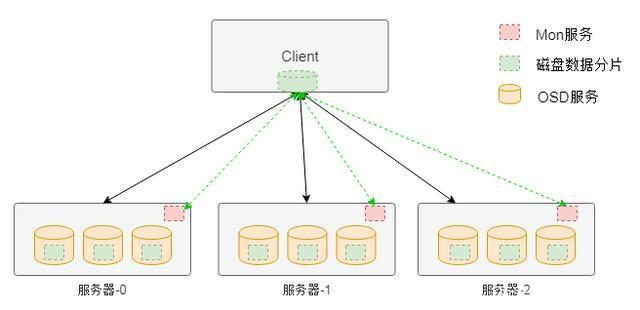
分布式存储通过将数据切分为多个片段并分散存储在不同物理节点上实现数据管理,其核心在于通过冗余设计确保数据可用性。当数据写入系统时,系统会自动将数据分片并生成冗余副本或校验信息,这些数据单元被分布到地理位置分散的存储节点中。即使部分节点发生硬件故障、网络中断或遭遇自然灾害,系统仍能通过剩余节点上的冗余数据重建原始信息,从而实现数据的高可靠性和持续可用性。
分布式存储的核心工作原理
数据分片与节点协作
分布式存储系统首先将原始数据分割为固定大小的数据块(通常在几十MB到几GB之间)。这些数据块通过特定算法(如一致性哈希或虚拟节点技术)被动态分配到集群中的不同存储节点。每个节点仅存储数据的一部分,这种设计不仅提升了存储效率,还通过并行访问机制提高了数据读写速度。例如,Hadoop分布式文件系统(HDFS)采用默认128MB的块大小,将大文件拆分为多个数据块进行分布式存储。
数据分布策略需要解决三个关键问题:如何平衡节点间的存储负载、如何优化数据访问延迟、如何应对节点动态加入或退出。典型系统采用环状拓扑结构或树状层级结构管理节点,通过元数据服务器或分布式哈希表(DHT)维护数据位置索引。当客户端请求数据时,系统根据索引定位存储节点,同时动态选择响应最快的节点提供服务。
数据一致性协议
在多副本写入场景中,系统需要确保所有副本保持数据一致性。Paxos和Raft算法是实现分布式共识的两大主流协议。以Raft为例,其通过选举机制确定主节点(leader),由主节点统一处理写请求并同步到从节点(follower)。只有当大多数节点确认写入成功后,系统才向客户端返回成功响应。这种"多数派写入"机制保证了即使部分节点故障,仍能保持数据的完整性和一致性。
对于强一致性要求不高的场景,系统可能采用最终一致性模型。例如Amazon DynamoDB通过向量时钟(Vector Clock)记录数据变更历史,在节点恢复后通过协调机制解决数据冲突。这种设计在提升系统可用性的同时,需要应用层具备处理短暂不一致状态的能力。
冗余设计:数据安全的数学保障
复制技术与纠删码
数据复制是最直观的冗余方案,典型如HDFS默认采用的三副本策略。每个数据块同时存储在三个独立节点上,当任一节点故障时,系统自动从其他节点复制数据生成新副本。这种方案实现简单且恢复速度快,但存储效率仅为1/3,对于PB级数据存储存在显著的空间浪费。
纠删码(Erasure Coding)通过数学编码提升存储效率。以Reed-Solomon码为例,假设将数据划分为k个数据块,并生成m个校验块,任意k个有效数据块即可恢复原始数据。当k=6、m=3时,存储效率提升至66%,同时能容忍任意3个节点故障。但该方案需要额外的编码计算资源,且数据重建过程可能消耗更多网络带宽。
动态修复与自愈机制
分布式存储系统内置持续监控机制,定期验证数据完整性。当检测到节点离线或数据损坏时,系统自动触发修复流程:首先定位受影响的数据块,然后从可用副本或校验块重建数据,最后将新数据写入健康的存储节点。例如Ceph的SCRUB机制每30天执行一次深度数据校验,确保数据的长期可靠性。
在灾难恢复层面,系统通过跨数据中心的数据分布实现地理冗余。Google Spanner数据库采用全球分布式部署,将数据副本分布在不同大洲的数据中心。当区域级故障发生时,系统能在秒级切换数据访问路径,确保业务连续性。这种设计需要解决跨地域数据同步的延迟问题,通常采用异步复制结合WAN优化技术实现。
技术选择的权衡逻辑
在实际应用中,冗余方案的选择需要平衡存储成本、访问性能和容错能力。对于实时交易系统等对延迟敏感的场景,常采用低冗余度的复制方案(如双副本+快速检测机制);而归档存储等场景则更适合高编码率的纠删码方案。新兴的本地恢复码(Locally Repairable Codes)通过优化数据重建过程的局部性,在降低修复带宽消耗方面展现出优势。随着非易失性存储器(如SSD)的普及,分层存储架构结合智能数据迁移策略,正在成为提升整体系统性价比的重要方向。
- 分布式存储 冗余设计 数据分片 数据一致性 纠删码

下一篇
什么是以太坊?它与比特币智能合约有何不同?
-

- 区块链百科
- 2025-09-09 12:13:00
- 25935
- 本文对比以太坊与比特币智能合约的差异,从架构(账户模型、EVM)、执行机制(gas计量、确定性)到应用生态(DApp数量、DeFi发展)展开分析,探讨技术路线差异及未来发展方向。
24小时热点



热点专题


 2445565